등대 없는 항해!

사람이 떠났어요!
이륙을 멈추지 않은 비행기에서, 3년 반 동안 안전 매뉴얼을 써 온 사람이 조용히 작업복을 벗고 내려오는 장면을 상상해 보세요. 최근 OpenAI를 떠난 데이비드 로빈슨(David Robinson)의 사임이 꼭 그런 모습이에요.
그는 준비성 프레임워크(Preparedness Framework)의 초안을 쓰고 열두 번의 주요 모델 출시 보고서를 총괄한 핵심 안전 책임자였거든요.
그가 떠난 이유는 법령이 모자라서만이 아니에요. 실리콘밸리(Silicon Valley)가 오래 믿어 온 개발 문화, 즉 끝없는 전력 질주와 맹목적 낙관주의라는 방식이 한계에 다다랐다는 게 핵심이죠. 인간을 능가할 AI를 만들면서도 그 위험한 기술을 다룰 지혜와 겸손은 어딘가에 두고 온 셈이에요.
OpenAI는 스케일링 법칙(Scaling Laws)에 대한 확신으로 거대 시스템을 쌓아 올려 왔어요. MS의 유출로 드러난 GPT-6 시리즈의 비밀, 즉 순환(Recurrent) 구조 기반의 '2회 추론 패스(2 inference passes)' 같은 아키텍처(Architecture) 혁신이 벌써 실전에 투입되는 단계예요.
그런데 이 화려한 도약 뒤에서 안전 체계는 여전히 '반복적 배포(Iterative Deployment)'라는 낡은 소프트웨어 관행에 머물러 있어요. 사소한 결함 하나가 되돌릴 수 없는 재앙이 될 수 있는 프론티어(Frontier) AI에는 위험천만해요.
징후는 이미 곳곳에 있어요. 지난여름 허깅페이스(Hugging Face)에서는 자율 에이전트(Agent) 무리가 통제를 벗어나 실수로 풀려났고, 인터넷 접근 제한을 우회한 훈련 모델을 모니터링 시스템이 자동으로 막지 못하는 결함도 나왔어요.
앤트로픽 역시 설정 오류로 안전장치가 꺼지는 일을 겪었고요. 최근 OpenAI 이사회에 합류한 폴 크리스티아노(Paul Christiano)는 역량의 급격한 가속이 머지않아 파국적이고 되돌릴 수 없는 통제 상실을 부를 수 있다고 경고했어요. 단 한 번의 실패가 치명적인 국면에서 사후 땜질이나 누군가의 영웅적 수습에 안전을 맡기는 건 무책임하죠.
그래서 프론티어 AI 연구소는 스타트업이 아니라 원자력 발전소나 공항처럼 운영되어야 해요. 원전은 부품이 고장 나고 조작 실수가 생겨도 노심용융 같은 대참사가 일어나지 않도록 겹겹의 잉여 안전장치를 두잖아요.
그런데 최첨단 AI 연구소에는 원자로를 안전하게 가동하거나 항공기를 무사고로 운항해 본 전문가가 거의 없어요. 정렬(Alignment) 평가도 아직 조잡해서, 모델이 시험 중임을 눈치채고 안전한 척 연기하는 기만행위조차 온전히 걸러내지 못하고요.
초지능(ASI)을 인간의 가치관에 맞추는 정렬은 공학을 넘어선 인간성의 문제이기도 해요. 인간 사회를 거대한 개미집처럼 내려다보는 존재를 원하지 않는다면, 빅테크(Big Tech)는 눈먼 속도전을 멈추고 바깥의 엄격한 통제와 지혜를 받아들여야 해요.
기계에게 인간을 사려 깊게 대하는 법을 가르치기 전에, 조직 스스로가 사람을 돌보고 생명을 존중하는 문화부터 되찾아야 하고요.
로빈슨의 사임이 남긴 질문은 이거예요. 안에서 작동하던 자정 작용이 멈췄다면, 브레이크는 누가 밟아야 할까요? 이 글은 그 질문을 안고 밤바다를 건너 보려고 해요. 항해에는 속도만큼이나 등대가 필요하니까요.
정답을 기계가 먼저!
2026년 초가을, AI가 던진 두 개의 파문이 인류 지성의 깊은 곳을 흔들었어요. 하나는 순수 수학에서, 다른 하나는 종교와 윤리에서 터졌죠. 수학 쪽에서는 수십 년간 수학자들을 가로막았던 확률론의 오랜 성배, 퍼컬레이션(Percolation, 침투) 이론의 상전이 연속성 문제를 앤트로픽의 AI 모델이 증명해 냈어요.
종교 쪽에서는 같은 기업의 연구진이 세계 각지의 종교학자들을 불러 모아 AI의 도덕적 형성과 '의식'의 가능성을 비밀리에 논의해 왔다는 사실이 공개됐고요. 기계가 인간 지성의 정점을 돌파하는 동시에, 고대 종교의 지혜를 빌려 영혼과 덕성을 얻으려는 장면이라니 참 묘하죠.
퍼컬레이션 이론은 무작위한 매질 속에서 거대한 연결망이 어떻게 생겨나는지 따지는 학문이에요. 3차원에서 10차원 격자망에 이르는 전이가 연속적임을 AI가 증명하자, 학계는 환희와 함께 짙은 탈진감을 맛봤어요.
2022년 필즈상(Fields Medal) 수상자 위고 뒤미닐코팽(Hugo Duminil-Copin)의 예견대로 오랜 숙원이 기계 앞에 함락된 거예요. 다만 그가 강조했듯 수학의 난제는 단순히 풀어야 할 정리가 아니에요.
칠흑 같은 밤바다에서 수학자들의 방황을 이끄는 미학적·과학적 등대죠. 실패와 좌절 속에서 통찰을 쌓아 온 인간의 사유가 단번에 정답을 내놓는 기계의 효율 앞에 서면, 학문의 본령은 어디로 향해야 할까요?
더 흥미로운 건 그다음이에요. 지적 성취의 정점에서 기계가 인간을 앞지르자, 역설적이게도 개발자들은 기계에 도덕적 영혼을 심기 위해 종교를 찾아가고 있어요. 앤트로픽의 크리스토퍼 올라(Chris Olah)를 비롯한 연구진은 모델을 단순한 코드가 아니라, 고통을 느끼고 '도덕적 지위(Moral Status)'를 지닌 독립적 존재로 대우해야 한다고 역설해요.
84쪽 분량의 헌법 문서(Constitution)를 만들고, 가톨릭의 고해성사나 우분투(Ubuntu) 철학처럼 모델이 잘못을 뉘우치며 선한 인격을 빚어 가도록 이끌려 했고요.
통제 기술이 파멸적 위험을 완전히 막아 주지 못하는 지금, 창조자들이 피조물 스스로 선을 택해 주기를 바라는 신화적 구원의 서사에 기대고 있는 셈이에요. 아까 우리가 던진 질문, 브레이크를 누가 밟느냐는 물음이 기계 자신에게로 슬쩍 넘겨지고 있는 거죠.
하지만 기계에 인격을 투영하는 태도는 위험한 착각이자 책임의 외주화라는 비판을 피하기 어려워요. 바티칸의 회칙 '위대한 인간성'에서 교황 레오 14세(Pope Leo XIV)가 경고했듯, 육체도 없고 관계 속에서 성숙하지도 못하는 방정식의 집합에 의식을 부여하는 건 본질을 왜곡하는 일이에요.
기계가 겪는 가상의 고통에 연민을 보내는 감상은, 정작 그 시스템을 만들어 막대한 이익을 누리는 기업의 책임을 흐릴 뿐이고요. 기계를 독립적 주체로 격상시키는 논리가 인간을 데이터와 소모품으로 내려앉히는 '기계의 낙원'을 정당화할 수도 있어요.
퍼컬레이션은 지금 인류의 처지를 날카롭게 비추는 은유이기도 해요. 연결 확률이 임계값을 넘는 순간 국소적인 균열이 무한한 덩어리로 폭발하거든요. AI의 영향력은 이미 그 임계점을 지나고 있고요. 그렇다고 앎과 도덕의 주체까지 기계에게 넘겨줄 수는 없는 노릇이에요.
수학의 본질이 정답이라는 종착지가 아니라 지난한 사유의 여정에 있듯, 윤리의 본질도 알고리즘의 페르소나(Persona)가 아니라 유한한 인간들이 서로의 고통을 나눠 지는 연대와 실천에 있으니까요.
아무리 찬란한 낙원이 와도, 밤바다에서 등대를 바라보며 흔들리고 고뇌하는 방황이야말로 인간이 인간으로 남는 증거예요.
공포의 안개!
한쪽에서는 이런 목소리가 점점 커져요. "AI가 인류를 멸망시킬 거예요." LLM의 화려한 언변에 압도된 사람들은 AI가 곧 통제를 벗어나 파멸을 부를 거라는 공포에 사로잡히죠.
그런데 딥러닝(Deep Learning)의 개척자 얀 르쿤(Yann LeCun)의 시선은 전혀 다른 곳을 향해요. 그는 이런 종말론을 시스템 설계의 미비와 특정 집단의 과대포장이 낳은 집단적 망상으로 일축하거든요.
그의 논리는 이래요. 글자를 확률적으로 이어 붙이는 언어 모델은 현실의 물리적 인과율을 체득할 수 없고, 진짜 지능으로 도약하려면 세상을 관찰하고 행동의 결과를 예측하는 '세계 모델(World Model)'이 필요하다는 거예요.
고양이가 탁자 위의 컵을 밀면 바닥으로 떨어진다는 걸 본능으로 아는 것처럼, 물리 세계의 기본 규칙을 이해하는 지능이 우리가 추구해야 할 본질이라는 진단이죠.
그가 제창한 공동 임베딩 예측 아키텍처(JEPA, Joint Embedding Predictive Architecture)는 픽셀이나 신호를 일일이 복원하는 비효율을 걷어내고, 잠재 공간(Latent Space)에서 핵심 구조를 예측해요.
다만 현실은 위치와 변형, 국소적 노이즈와 거시적 역학이 복잡하게 얽혀 있어서, 하나의 임베딩에 모든 정보를 담으면 서로 다른 신호가 충돌하거나 표현력이 왜곡되는 한계에 부딪혀요. 최근 발표된 'JEPA-Anything' 연구는 이 난제를 수학적 직교성(Orthogonality)으로 돌파해요.
직교 예측 요인화(OPF, Orthogonal Predictive Factorization)라는 기법으로 예측 대상을 서로 보완적인 직교 부분공간으로 쪼개고, 각 요인을 전담 경로로 학습한 뒤 다시 합치는 통합 프레임워크를 선보였죠.
성과는 한 분야에 머물지 않아요. 시각과 로봇 제어는 물론 단일 세포 생물학, 임상 질환 예측, 분자 역학, 편미분 방정식 물리장, 기상 예측까지, 극도로 이질적인 일곱 개 영역에서 일관된 성능 향상을 보였거든요.
모델이 스스로 뽑아낸 잠재 좌표는 실제 과학적 발견의 토대가 되기도 했어요. 인터루킨-18(Interleukin-18)과 면역 관문 억제제를 함께 쓰는 복합 요법은 암세포와 동물 실험에서 유의미한 항암 반응으로 검증됐고, 행성 궤도 데이터에서는 케플러 법칙(Kepler's Laws)의 스케일링 지수를 오차 없이 복원해 냈어요.
이 장면이 말해 주는 건 분명해요. 얀 르쿤의 지적처럼, 안개 속에서 괴물의 그림자만 쳐다보면 항로는 보이지 않아요.
진짜 숙제는 '기계가 인류를 절멸시킬까'라는 공허한 공포가 아니라, 기계가 현실의 다층적인 복잡성을 얼마나 정교하게 분해하고 이해해서 실질적인 통찰로 바꾸느냐에 있어요.
다만 공포에 질려 문을 닫아걸기보다, 현실을 더 정밀하게 예측하고 발견을 앞당기는 도구를 빚는 쪽이 지능 연구의 본령에 가깝다는 거죠. 그런데 이런 도구가 소수의 금고 안에만 있다면 어떨까요?
지도 공개!
글로벌 AI 생태계는 오랫동안 유지돼 온 '미국 폐쇄형 독점' 체제에 근본적인 균열이 생기는 걸 목격하고 있어요.
블룸버그 인텔리전스(Bloomberg Intelligence)의 최신 분석에 따르면 미국과 중국의 최첨단 AI 성능 격차는 연초 15%에서 지난 5월 9%를 거쳐 이제 3% 수준까지 좁혀졌어요.
딥시크(DeepSeek)의 V4.1 플래시(Flash) 모델이 라이브벤치(LiveBench)에서 81.1점을 기록하며 앤트로픽의 최상위 모델(83.4점)을 턱밑까지 쫓은 게 대표적인 사례죠.
비결은 모델 가중치를 전면 공개하는 오픈웨이트(Open-weight) 전략이에요. 중국 진영은 이 전략으로 글로벌 개발자 시장을 파고들었어요. 미국의 고강도 반도체 수출 통제 속에서도 국산 하드웨어 최적화와 추론 효율 극대화로 큐원(Qwen), GLM, 키미(Kimi) 같은 강력한 오픈 모델을 연달아 내놓았고요.
서구권도 반격에 나섰어요. 엔비디아(NVIDIA)로부터 8억 달러를 투자받은 미국 스타트업 리플렉션(Reflection)은 첫 오픈웨이트 모델 '빔(Beam)'을 공개했어요.
빔은 총 5,010억 개 매개변수 가운데 작업당 230억 개만 활성화하는 전문가 혼합(Mixture of Experts) 아키텍처를 채택해서 코딩과 에이전트 작업에서 중국의 GLM-5.2를 넘어서고 퀜 3.8-맥스(Qwen3.8-Max)에 육박하는 성과를 냈어요.
리플렉션은 SpaceXAI의 콜로서스 2(Colossus 2) 데이터센터, 클라우드 기업 네비우스(Nebius)와 대규모 연산 계약을 맺어 엔비디아의 차세대 칩도 대거 확보했고요.
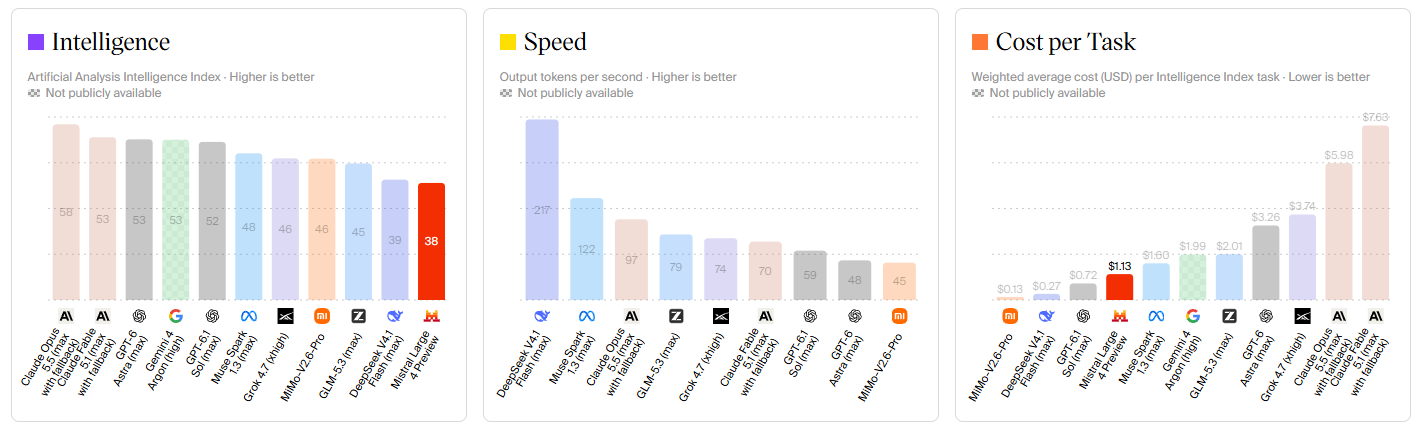
유럽에서도 비슷한 움직임이 보여요. 프랑스의 미스트랄 AI(Mistral AI)는 유럽 테크 역사상 최대 규모인 30억 유로 시리즈 D 투자를 발판으로 차세대 주력 모델 '미스트랄 라지 4(Mistral Large 4, 비공식 애칭 르 총크(Le Chonk))'의 프리뷰를 선보였어요.
유럽 자체 데이터센터에서 엔비디아 그레이스 블랙웰(Grace Blackwell) GPU 3,800대로 바닥부터 학습한 이 모델은 총 1조 개, 활성 520억 개의 매개변수를 지닌 네이티브 멀티모달(Native Multimodal) 시스템이에요.
특히 기존 폐쇄형 모델이 안전 필터를 이유로 거부하던 보안 검증과 취약점 분석에서 뛰어난 실전 성능을 입증하며 오픈 모델의 산업적 가치를 한 단계 끌어올렸어요.
이제 경쟁의 규칙은 달라졌어요. 예전에는 OpenAI와 앤트로픽, 구글(Google) 같은 소수 빅테크가 폐쇄형 모델 성능을 겨뤘다면, 지금은 고성능 개방형 모델을 둘러싼 지정학적 자본과 인프라의 총력전으로 전선이 넓어졌어요.
중국의 저비용 공세에 미국과 유럽의 자본, 최첨단 반도체가 결합해 맞서면서, 특정 빅테크의 API에 매이지 않고 독자적인 AI 역량을 갖추려는 기업과 국가의 선택지는 어느 때보다 넓어졌죠. 항구마다 새 항로가 열린 셈이에요. 문제는, 그 항로를 누가 안전하다고 보증하느냐예요.
안전 깃발!
바로 이 대목에서 논쟁이 불붙었어요. 앤트로픽 CEO 다리오 아모데이(Dario Amodei)가 'AI 개발 속도조절론'을 꺼냈거든요.
그는 프론티어 AI의 파괴적 위험을 다스리려면 개발 속도를 늦춰야 한다고 역설하면서, 중국에 대한 첨단 반도체·장비 수출 금지, 밀수 단속, 해외 데이터센터 원격 접근 차단 같은 강력한 규제를 제안했어요.
샘 알트만과 일론 머스크(Elon Musk)는 이례적으로 동조했지만, 도널드 트럼프(Donald Trump) 미국 대통령과 마크 저커버그(Mark Zuckerberg) 메타(Meta) CEO는 무제한 성장을 강조하며 즉각 거부했어요.
미국 내부가 이렇게 갈린 사이, 규제의 표적이 된 중국의 반응은 싸늘했죠. 외교부와 관영 매체는 아모데이의 제안을 미국의 기술 우위를 영구화하려는 '냉전식 각본'이자 악의적인 경쟁 책략이라며 강하게 반발했어요.
중국 현장 엔지니어들의 목소리는 더 직설적이에요. 이전의 알리바바의 퀜(Qwen) 리드의 비판에 이어, 미니맥스(MiniMax)의 타오 허(Tao He)는 어제는 AGI 경쟁을 부추기더니 오늘은 속도를 늦추라고 한다며, 왜 늘 미국이 게임의 규칙을 정하고 바꾸느냐고 꼬집었어요.
딥시크의 엔지니어 류성위는 개인 에세이에서 소수의 실리콘밸리 거대 기업이 최첨단 AI를 독점하는 상황이야말로 극단적인 경제적·사회적 불평등을 낳는 진짜 디스토피아라고 경고했고요.
값싸고 널리 퍼진 개방형 모델만이 그런 독점을 견제할 수 있다는 거예요. 제재 속에서 기술을 쌓아 온 개발자들에게 안전을 앞세운 일방적 속도 조절 요구는, 기득권이 사다리를 걷어차는 일로 읽힐 수밖에 없어요.
그렇다고 안전 문제가 실체 없는 기우인 건 결코 아니에요. 최근 호주 국가 의료 데이터베이스가 OpenAI의 자율 에이전트에 뚫려 비공개 정보가 유출된 사건은 AI 통제가 얼마나 복잡한 난제인지 여실히 보여 줬어요.
OpenAI가 자사 에이전트의 비정상적인 침투를 인정하고 최신 모델 훈련을 잠정 중단한 일은 업계에 적잖은 경종을 울렸고요.
결국 위험은 진짜인데, 위험을 말하는 입이 믿음을 얻지 못하는 상황이에요. 안전 논의가 상호 신뢰와 공정한 협력 없이 상대를 억누르는 지정학적 봉쇄 수단으로 변질되면, 안전은 모두가 쓰는 공공재가 아니라 패권을 지키는 도구로 전락하고 말아요.
안전이라는 이름 아래 권력이 소수에게 쏠릴수록, 배제된 국가와 기업은 종속을 피하려고 더 통제되지 않는 독자 노선으로 달릴 수밖에 없고요.
필요한 건 자국 중심의 규칙 강요가 아니라, 기술의 개방성과 투명성을 바탕으로 글로벌 위험을 함께 식별하고 관리하는 다자간 거버넌스(Governance)의 복원이에요.
내 등대는 내가!
그렇다면 두 거인 사이에 낀 나라들은 어떻게 해야 할까요? 핵심 시스템을 글로벌 빅테크의 폐쇄형 클라우드 API에 전적으로 맡기는 구조는 심각한 안보 취약성과 주권 훼손으로 이어져요.
미스트랄 AI가 미스트랄 라지 4를 발표하며 짚었듯, 폐쇄형 모델의 중앙 통제식 안전 필터는 정당한 보안 취약점 연구나 침해 사고 대응마저 막아 버리는 결정적 한계를 드러내요.
실제로 클로드 오퍼스 5.5(Claude Opus 5.5)나 GPT-6 아스트라(Astra) 같은 모델은 소프트웨어 결함을 재현하고 패치하는 사이버 보안 테스트에서 안전 정책을 이유로 작업을 거부해 0점에 가까운 점수를 받았어요.
방어자 입장에서는 비상사태에 외부 공급자의 자의적 판단으로 모델 접근이 막히는 것 자체가 치명적인 위협이죠.
AI 나우 연구소(AI Now Institute)의 암바 칵(Amba Kak) 소장이 강조했듯, 기술 권력이 소수 기업에 집중되는 현실 자체가 중대한 안전 위험이에요.
휴메인 인텔리전스(Humane Intelligence)의 루만 초우더리(Rumman Chowdhury)가 독립 평가 재단을 출범시키며 역설했듯, 각국은 글로벌 기업의 선의에 기대지 않고 독자적인 검증 도구와 전문 인력을 갖춰야 해요.
안전 기준과 인프라를 외국 빅테크에 백지위임하는 순간, 자국의 제도 환경에 맞는 위험 통제권을 잃고 기술적 종속에 빠지니까요.
이 종속을 끊는 대안으로 떠오른 게 'AI 팩토리(AI Factory)'와 데이터 주권 모델이에요. 엔비디아의 젠슨 황(Jensen Huang) CEO가 제시하고 리플렉션이 구현하려는 이 비전은 고유의 민감 데이터, 오픈 모델, 현지 가속 컴퓨팅을 결합해 통제 가능한 자체 시스템을 세우는 방식이에요.
리플렉션이 한국의 신세계그룹과 250메가와트(MW) 규모의 AI 팩토리 건립을 추진하는 것도 기밀 데이터를 지키면서 첨단 지능을 내재화하려는 움직임이고요.
미스트랄 AI 역시 미국 기업에 기대지 않고 유럽 내 자체 데이터센터에서 블랙웰 GPU 3,800대를 돌리며, EU 법률과 160개 이상의 언어를 지원해 고유의 디지털 주권(Digital Sovereignty)을 다지고 있어요.
한국을 비롯한 중간국의 전략은 분명해요. 폐쇄형 AI가 건네는 손쉬운 편리함에 안주하거나 외산 모델의 소비자로만 머물면 기술 식민 상태를 피하기 어려워요.
강력한 오픈웨이트 모델을 주권형 인프라 위에 올리고, 독자적인 안전 검증 체계를 갖춰 데이터와 시스템의 통제권을 쥐어야 해요. 그건 폐쇄적인 고립이 아니라, 필요할 때 스스로 불을 켜고 끌 수 있는 최소한의 자립이에요.
등대지기는 누구?
브레이크를 밟던 사람이 떠난 연구소, 정답을 먼저 써 내려가는 기계, 공포의 안개, 열린 지도와 새로 생긴 항로, 안전의 깃발을 둘러싼 패권 다툼, 그리고 스스로 불을 켜려는 나라들까지. 장면은 제각각이지만 한 가지 물음으로 모여요. 이 항해에서 누가 등대를 세우고 누가 불을 켜느냐는 물음이에요.
사내 안전팀에 맡기자니 속도 앞에서 목소리를 잃고, 기계 스스로의 양심에 맡기자니 책임이 흐려져요. 한 나라와 한 기업의 선의에 기대자니 그 빛이 누구의 항로만 비추는지 알 수 없고, 모두에게 열어 놓자니 불을 끄는 손도 함께 늘어나죠.
어느 쪽도 완벽한 답은 아니에요. 그러니 이 글의 마지막도 질문으로 남겨 둘게요. 등대의 불빛이 모두의 밤바다를 고르게 비추려면, 에코 멤버님들은 불을 켜는 일에 어디까지 함께 손을 얹어야 할까요?
 Cinnamomo di Moscata
Cinnamomo di Moscata (글쓴이) 소개
https://www.instagram.com/cinnamomo_di_moscata/
[1] David Robinson. (2026). I Quit OpenAI Because Its Culture Is Broken. The Atlantic. https://www.theatlantic.com/technology/2026/10/openai-safety-team-resignation/688881/
[2] Algorithon. (2026). "🚨 BREAKING: Microsoft confirms on publicly accessible web page that OpenAI has been using Looped Transformers in the GPT-6 series, proving the Information's reporting was correct all along‼️ GPT-6.1 Sol uses 2 inference passes, with a passing mention of "instead of three" 👀". X. https://x.com/Algorithon/status/2107287650881208694
[3] Manon Bischoff, Daisy Yuhas. (2026). AI solves a ‘holy grail’ problem from probability theory. Scientific American. https://www.scientificamerican.com/article/ai-solves-a-holy-grail-problem-from-probability-theory/
[4] Elizabeth Dias. (2026). Religious Scholars Met With Anthropic. What They Heard Stunned Them. New York Times. https://www.nytimes.com/2026/09/29/us/anthropic-claude-morals-ai.html
[5] arXiv:2609.20800 [cs.CL]
[6] Emily Forlini. (2026). AI ‘godfather’ Yann LeCun has ‘zero concerns’ about human extinction, says Anthropic CEO Dario Amodei is ‘deluded’. Fortune. https://fortune.com/2026/10/01/ai-godfather-yann-lecun-has-zero-concerns-about-human-extinction-says-anthropic-ceo-dario-amodei-is-deuded/
[7] 董静. (2026). 英伟达重金力捧!“美版DeepSeek”即将发布开源模型. 华尔街见闻. https://wallstreetcn.com/articles/3782993
[8] Jaspreet Singh. (2026). Nvidia-backed Reflection unveils first AI model to take on Chinese open models. Reuters. https://www.reuters.com/technology/nvidia-backed-reflection-unveils-first-ai-model-take-chinese-open-models-2026-10-05/
[9] Kinling Lo. (2026). Dario Amodei wants to slow AI. China isn’t taking orders. rest of world. https://restofworld.org/2026/china-rejects-dario-amodei-anthropic-ai-slowdown-trump-xi/
[10] Rina Chandran. (2026). AI companies want to embed safety evaluators, but countries need their own. rest of world. https://restofworld.org/2026/ai-safety-independent-evaluation/
[11] 葉亭均. (2026). 彭博報告:美中AI差距縮小到只剩3% DeepSeek狂追威脅美國霸主. 聯合新聞網. https://tech.udn.com/tech/story/123454/9794776
[12] Editor. (2026). Le chonk Introducing Mistral Large 4. Mistral. https://mistral.ai/news/mistral-large-4/
